LLM-Kostenkontrolle und Governance mit LiteLLM
Ein Überblick über die Möglichkeiten des Open-Source LLM-Gateways
Die Nutzung von LLMs in Unternehmen erfordert Übersicht
LLMs sind in vielen Teams angekommen: Entwickler*Innen nutzen Claude Code, CoPilot oder Codex, im Support helfen Modelle bei der Eingangsbehandlung und dem Formulieren von Antworten, und an einigen Stellen übernehmen automatisierte Agenten eigenständig Aufgaben wie Monitoring oder Ticket-Sortierung. Allerdings läuft bei vielen Unternehmen die Adoption von LLM-basierten Werkzeugen schneller, als die interne Governance sich anpassen kann. Eine der grundlegenden Fragen ist oft: Wo werden die LLM-Kosten eigentlich genau verursacht?
Ohne Antwort darauf bleiben am Monatsende nur Zahlen auf den Rechnungen der verschiedenen Modellanbieter - ohne Kontext, ohne Ansatzpunkt zum Optimieren, mitunter noch nicht einmal nach User-IDs aufgeschlüsselt. Abhilfe schafft hier ein zentraler Gateway-Ansatz, um im Unternehmen LLMs anzubieten: Sämtlicher LLM-Traffic, egal ob von Menschen oder von Software ausgelöst, läuft über ein internes Gateway. LiteLLM, ein Open-Source-Proxy für den Zugriff auf verschiedenste KI-Modelle ist ein solches Gateway. Mit LiteLLM lassen sich die Dienste verschiedener LLM-Anbieter (SaaS oder selbst gehostet), sowie Zugang zu internen MCP-Servern bündeln, sowie die Kosten kontrollieren und zuordnen
Kosten dort sichtbar machen und abbilden
Der erste Schritt ist simpel: Jedes Team bekommt in LiteLLM ein eigenes Budget und eine eigene Übersicht. So lässt sich auf einen Blick beantworten, welche Abteilung wie intensiv arbeitet und ob sie noch im vorgesehenen Rahmen liegt:
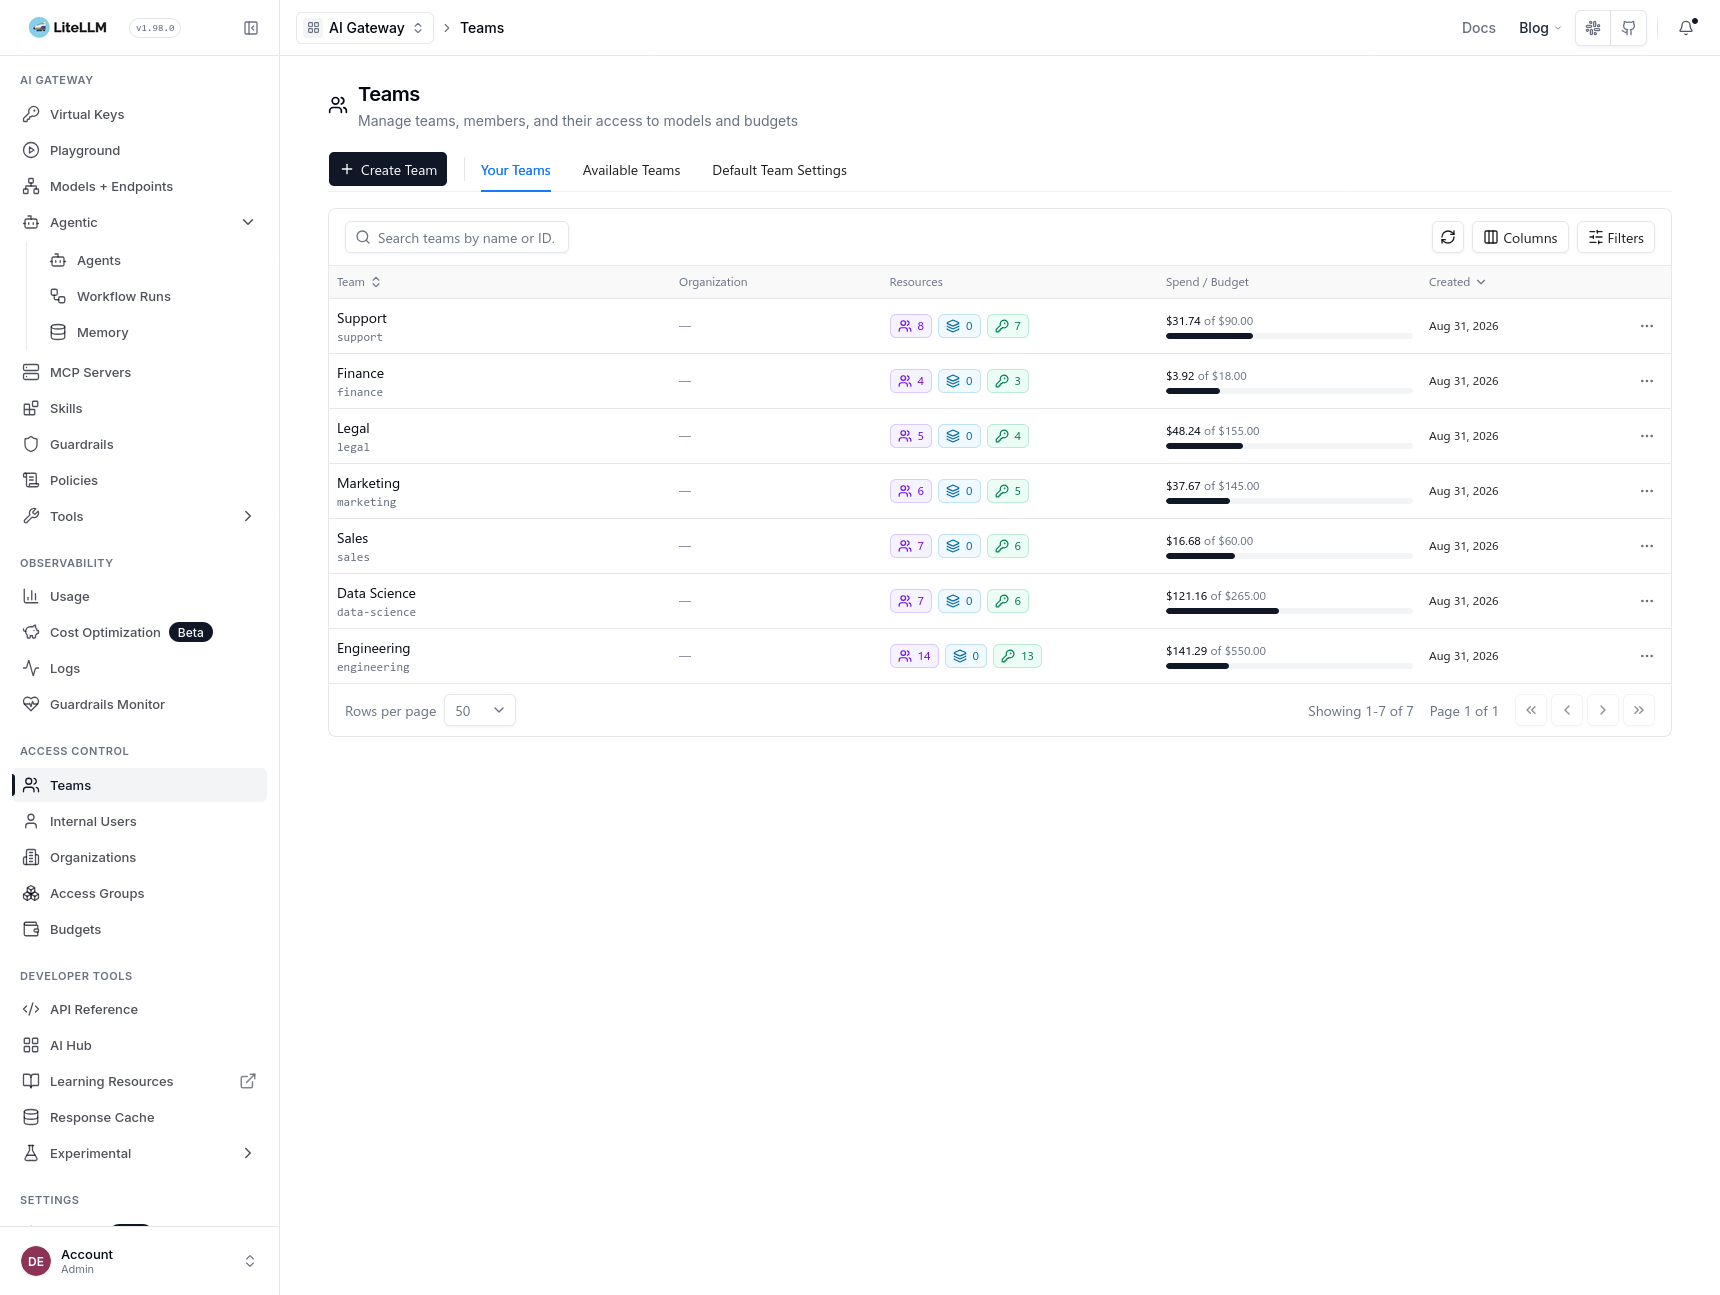
Support-Team: rund ein Drittel des Budgets ausgeschöpft
Rechtsabteilung: moderate Nutzung, deutlich unter dem Limit
Data-Science-Team: höchste Auslastung, nahe am Budgetrahmen
LiteLLM bündelt dabei den Zugang zu Modellen und legt die Kosten verschiedener Anbieter direkt auf Teams und Usern um und spart dadurch die manuelle Korrelation mehrere Rechnungen am Monatsende.
Auch Agenten sind Kostenstellen
Was in der Diskussion um KI-Kosten oft übersehen wird: Automatisierte Agenten, etwa für Systemmonitoring, Incident-Management oder Code-Reviews, laufen oft im Hintergrund, permanent und unbeaufsichtigt. Ein Agent, der rund um die Uhr Metriken überwacht, kann im Monat mehr Kosten verursachen als ein ganzes Entwicklungsteam zusammen.
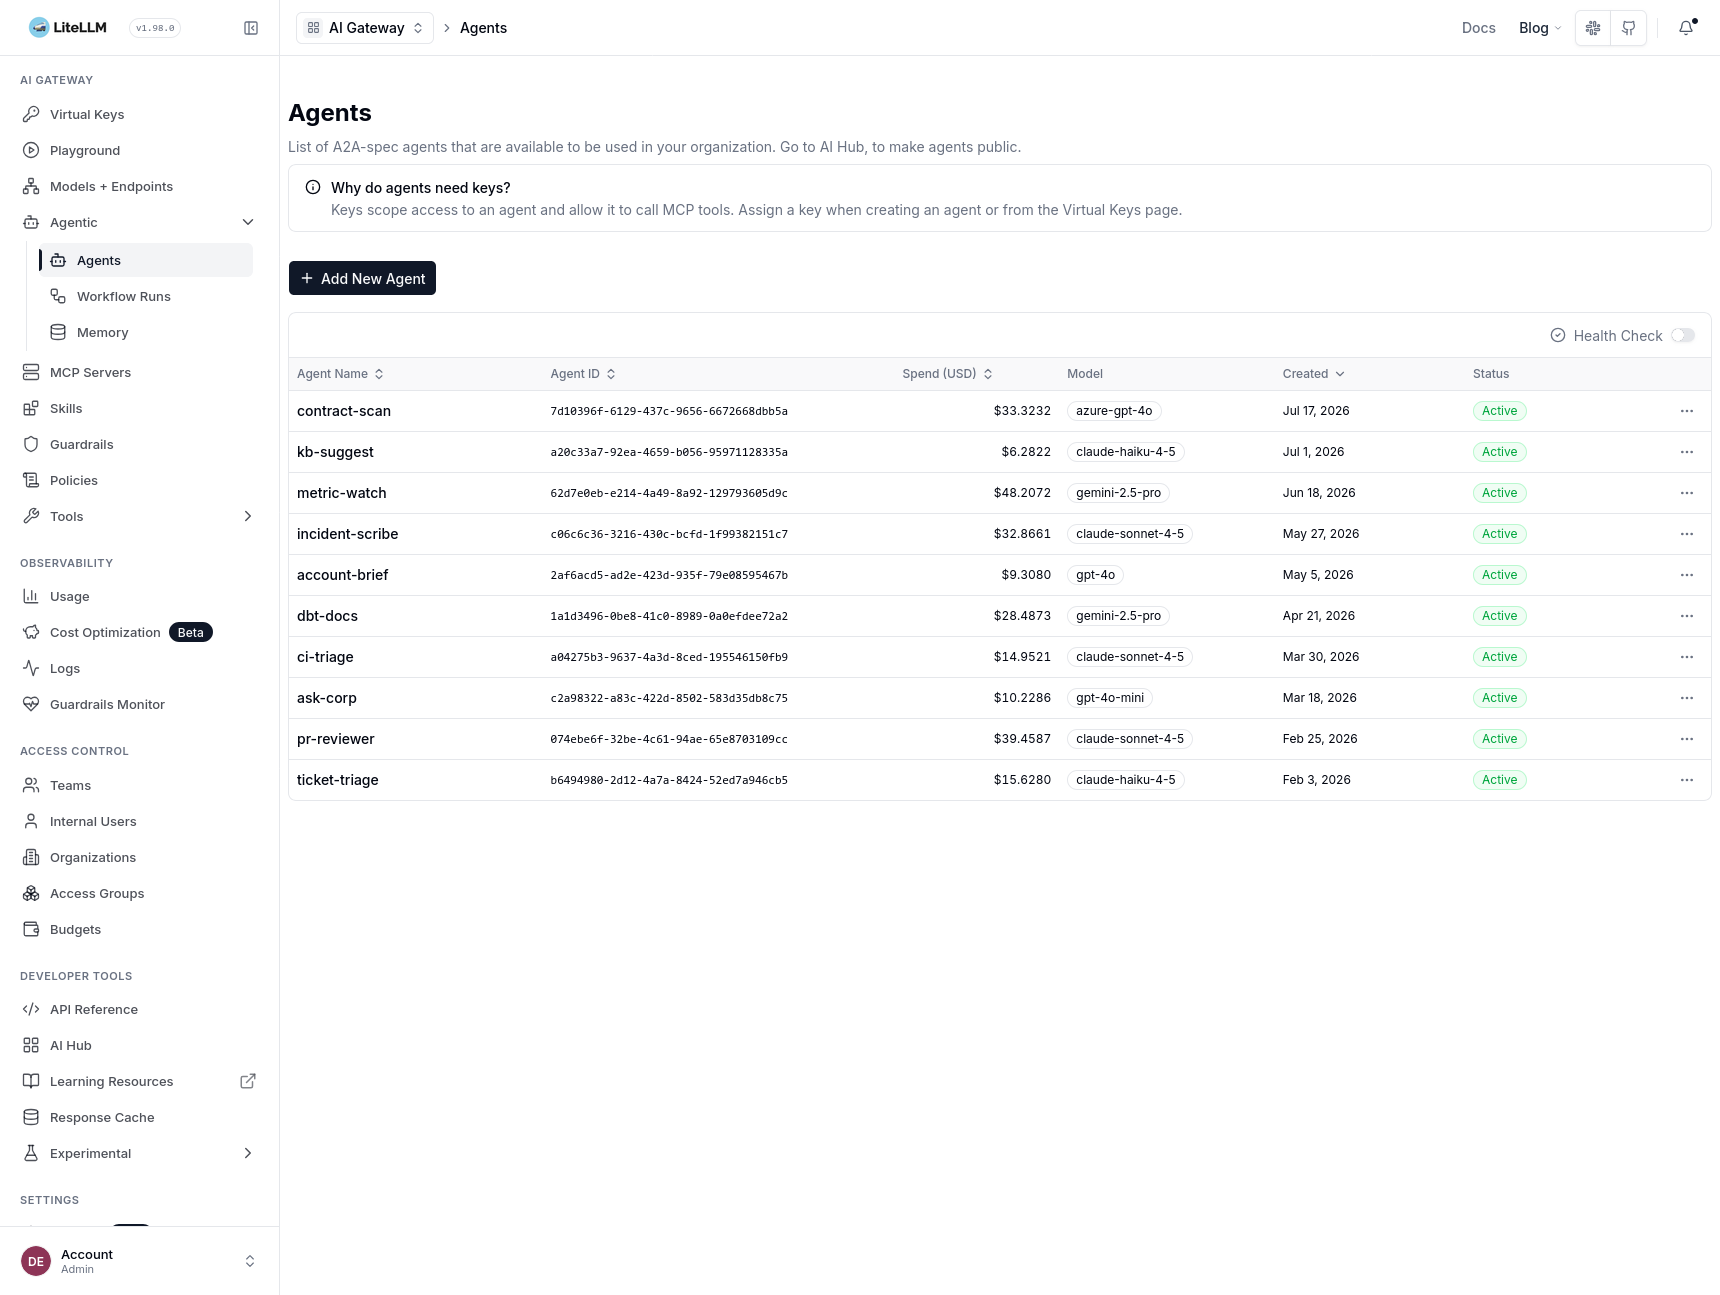
Deshalb behandelt LiteLLM Agenten wie eine eigene Kostenstelle, mit eigenem Modell, eigenem Verbrauch und eigener Sichtbarkeit. Das macht es möglich, frühzeitig zu erkennen, wenn die Kosten für einen einzelnen Agenten unerwartet aus dem Rahmen laufen.
Kostengrenzen durch Budgets setzen
Transparenz ist die eine Seite, Kontrolle die andere. LiteLLM erlaubt es, Budgets auf Team- und Userebene zu setzen: Wird ein Limit erreicht, können weitere Anfragen automatisch gestoppt oder umgeleitet werden, ganz ohne manuelles Eingreifen. Dadurch wird ein Frühwarnsystem geschaffen, das es Teams erlaubt, ihre LLM-Nutzung zu kontrollieren, bevor am Monatsende eine böse Überraschung in Form der Rechnung wartet.
Governance und Kontrolle durch Guardrails und Policies
Budgets regeln den Tokenverbrauch von Teams. Genauso wichtig ist aber die Frage, wie eine Anfrage an ein Modell aussehen darf und was mit der Antwort passiert, bevor sie zurückkommt. Dafür bietet LiteLLM an, Guardrails für Anfragen einzusetzen: automatisierte Prüfungen, die vor, während oder nach einer Modellanfrage greifen. Damit lassen sich unter anderem Versuche erk>ennen, ein Modell gezielt zu manipulieren. Personenbezogene Daten wie E-Mail-Adressen oder Kreditkartennummern lassen sich automatisch maskieren, versehentlich mitgeschickte Zugangsdaten abfangen und Inhalte können gegen definierte Richtlinien geprüft werden.
Da sich solche Prüfungen nicht nur global, sondern gezielt pro Team oder pro Zugang festlegen lassen, kann etwa die Finanzabteilung strengeren Prüfungen unterliegen als ein internes Entwicklungsteam. Hierbei können verschiedene Guardrails zu Policies zusammengefasst werden, die auf Teams verteilt werden können.
Woher weiß das System eigentlich, was ein Modellaufruf kostet?
Damit LiteLLM Kosten überhaupt berechnen kann, braucht es eine Preisgrundlage. Diese erfolgt im Augenblick über eine hinterlegte Preisliste. Dafür greift das System auf eine öffentliche, community-gepflegte Preisliste zurück, die für gängige Modelle die Kontextgrenzen, sowie Kosten pro Token, Anfrage, oder Zeiteinheit hinterlegt. Jede Anfrage wird auf Basis dieser Preistabelle berechnet.
Das heißt einerseits, dass diese Preisliste intern manuell gepflegt werden müssen, LiteLLM bietet aber auch die Möglichkeit, individuelle Overrides zu konfigurieren, wie etwa prozentualen Discounts. Darüber hinaus lassen sich so auch ohne große Hürden Kosten für selbst gehostete Modelle hinterlegen, um diese intern verrechnen zu können.
Muster erkennen und Anfragen analysieren
Besonders aufschlussreich wird es, wenn man sich die Nutzung über die Zeit ansieht. In unseren Beispieldaten zeigte sich etwa ein deutlicher Rückgang der Kosten am Wochenende ein klares Zeichen dafür, dass der Großteil der Ausgaben tatsächlich von Angestellten verursacht wird, nicht von durchgehend aktiven Agenten. Solche Erkenntnisse helfen enorm bei der Frage, wo sich Optimierung am meisten lohnt.
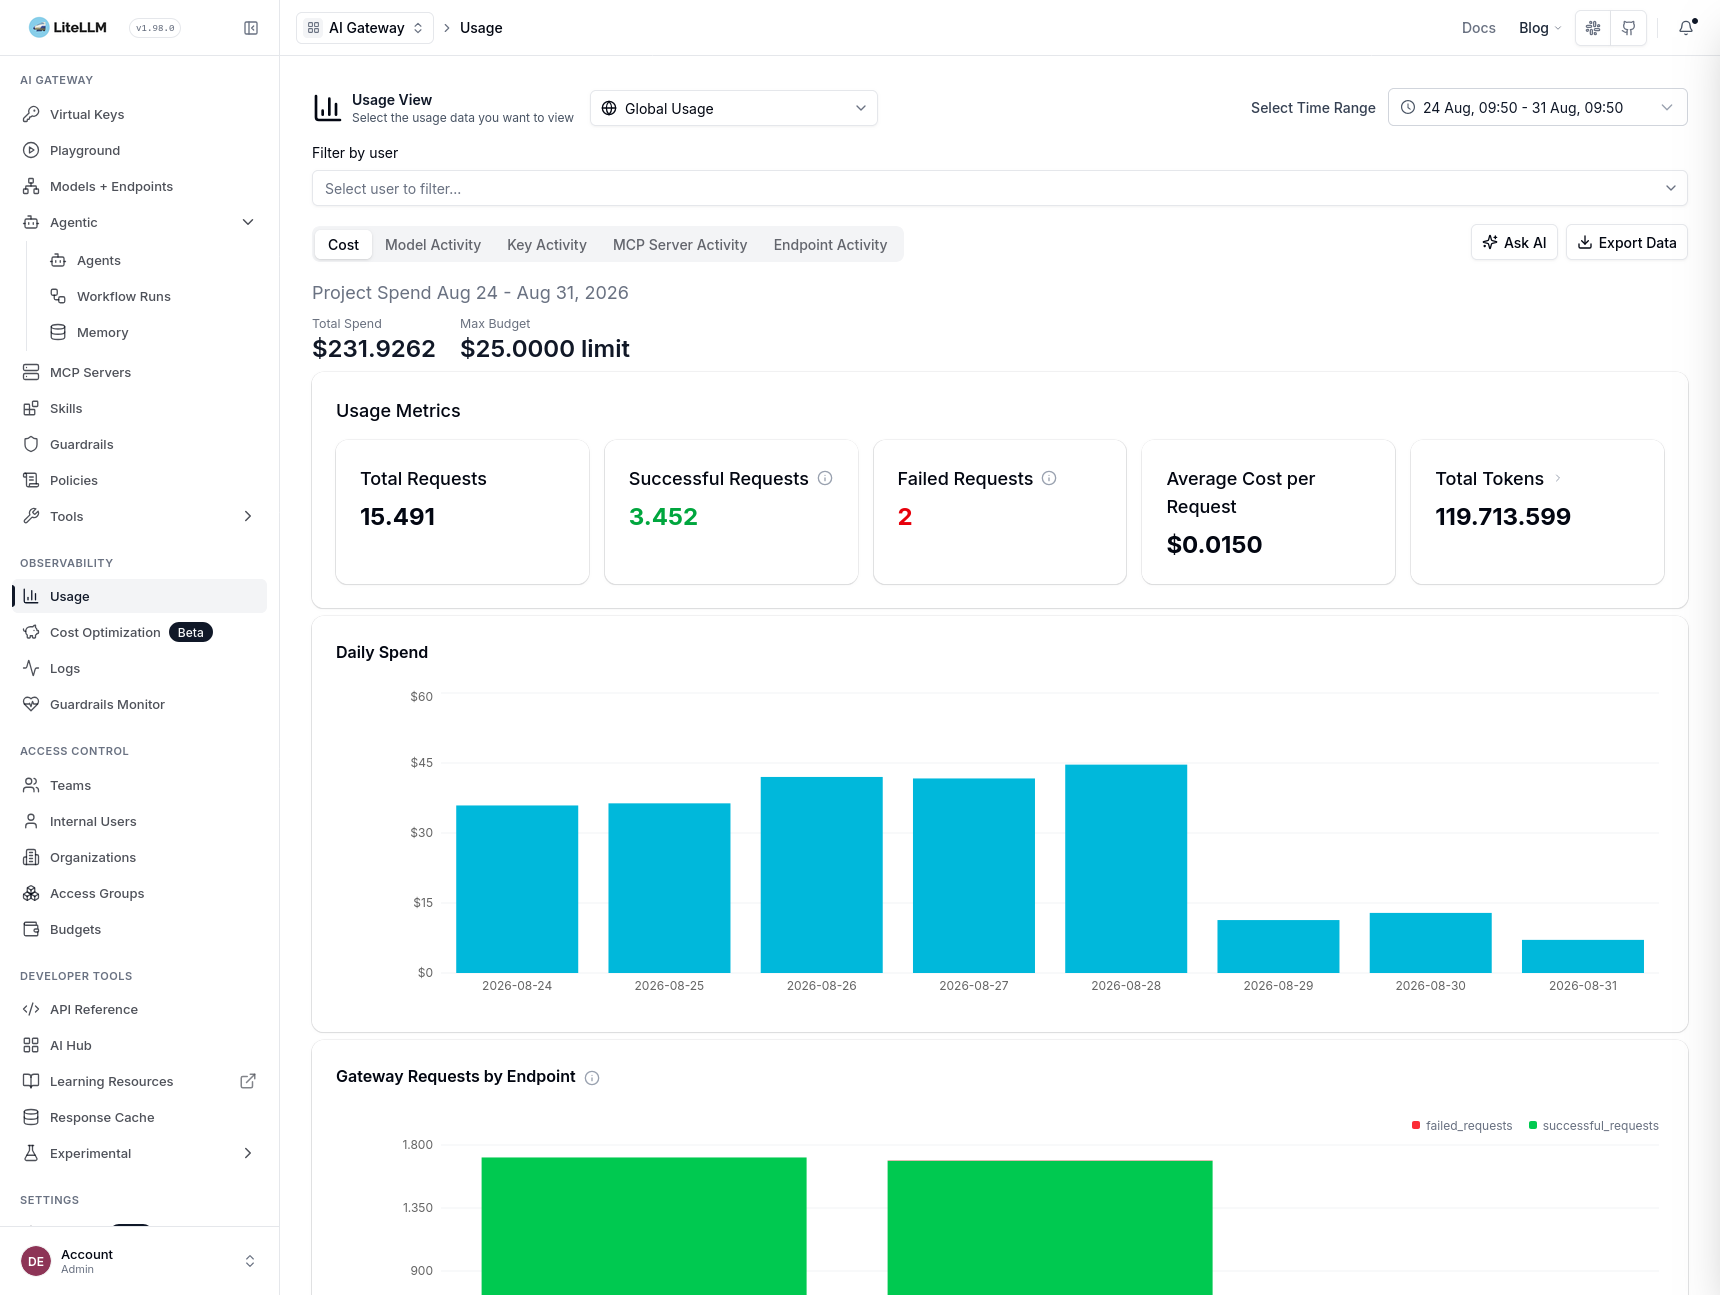
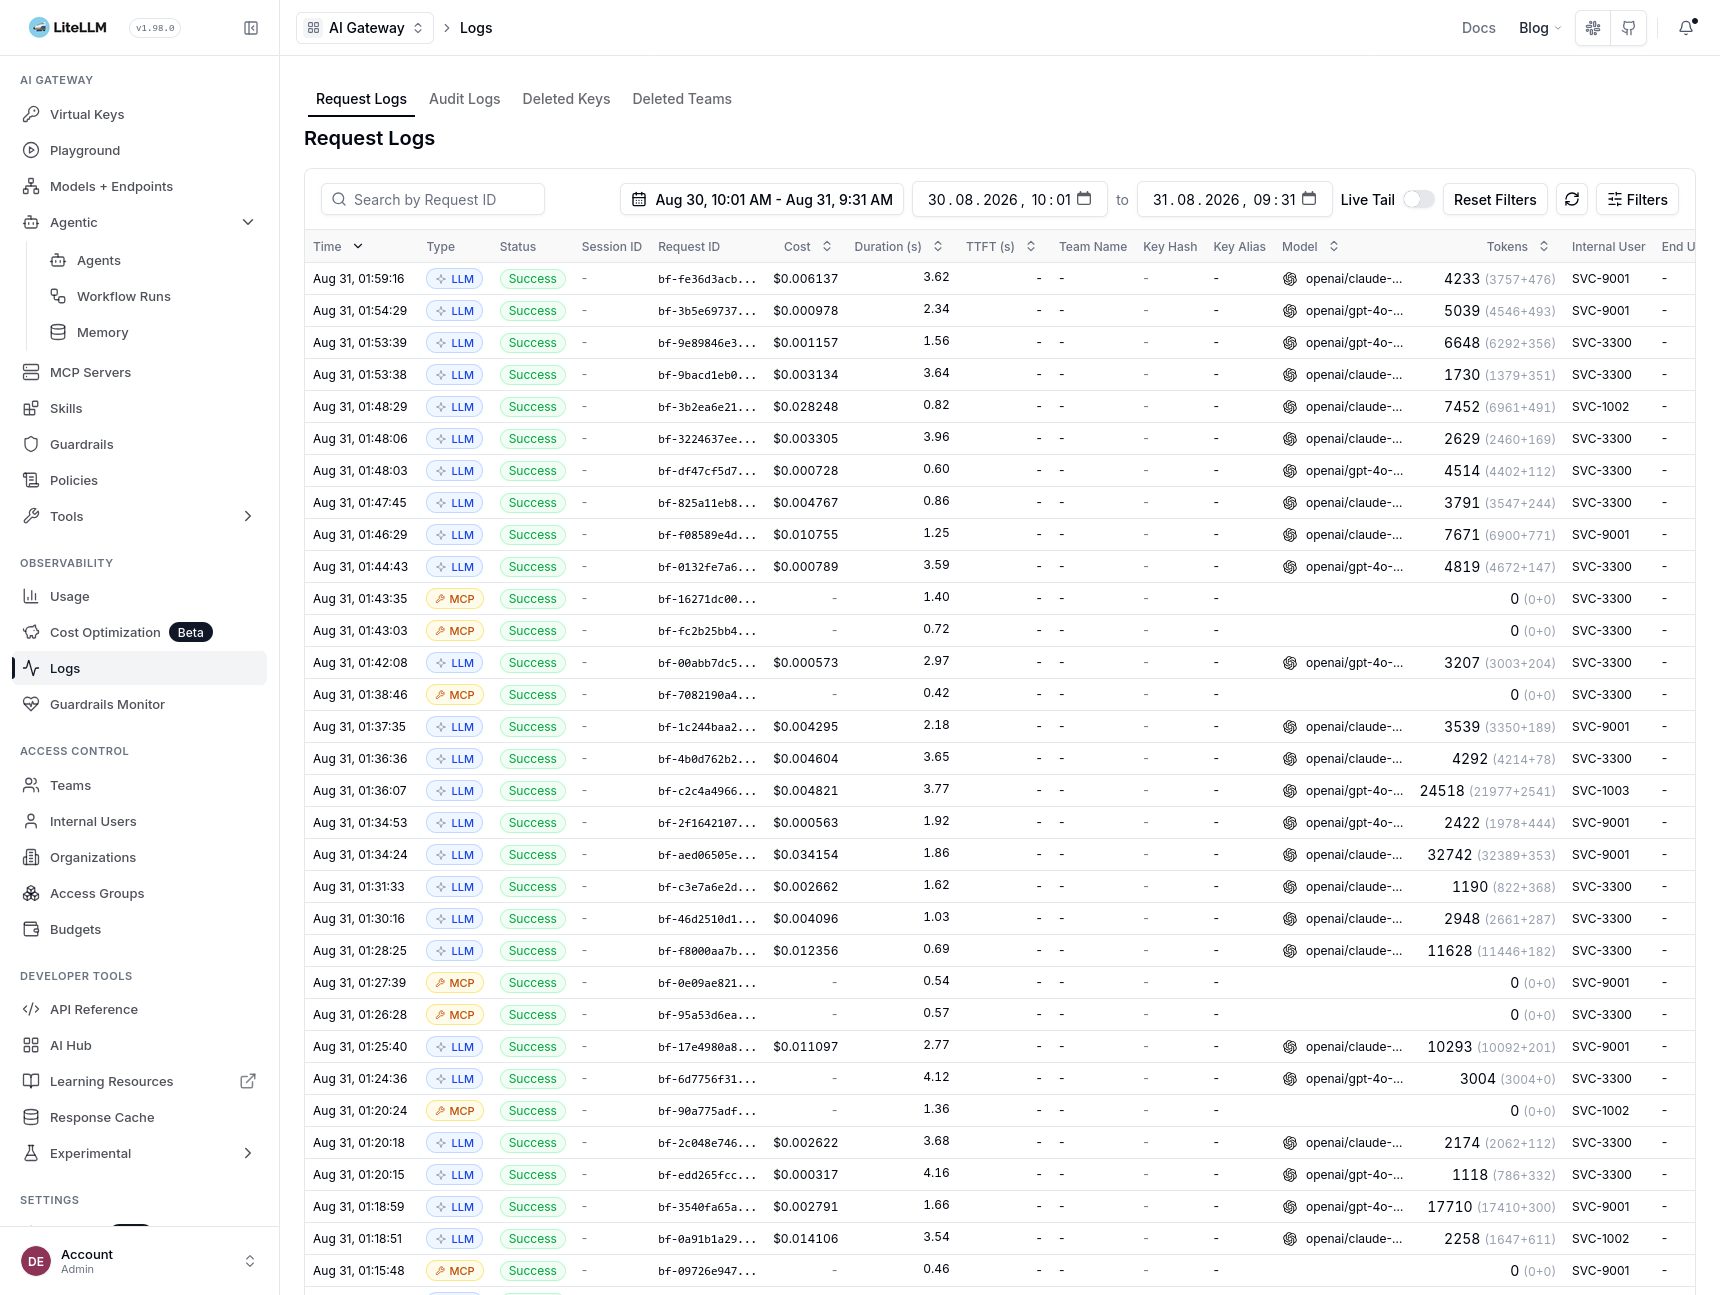
Für Detailfragen à la “Was genau hat diese eine teure Anfrage gekostet, wer hat sie ausgelöst, welches Modell wurde verwendet?” lässt LiteLLM zu, die gesammelten Daten bis auf den einzelnen Request herunterzubrechen. Das Protokoll zeigt pro Zeile Kosten, Dauer, genutztes Modell, Tokenanzahl und die verantwortliche Kostenstelle, berechnet auf Basis genau jener hinterlegten Preise.
Fazit
Kostenkontrolle bei LLMs erfordert passende Monitoring-Infrastruktur. Mit LiteLLM als zentralem Gateway lässt sich jede Anfrage, ob von einem Entwickler oder einem Agenten, ob extern eingekauft oder intern betrieben, einem klaren Verursacher zuordnen, und gleichzeitig durchsetzen, welche Inhalte und Daten diese Anfragen überhaupt enthalten dürfen. Das schafft nicht nur Kostentransparenz, sondern hilft auch, die Firma vor Manipulationsversuchen, oder Datenlecks aus versehentlich in Prompts gelandeten sensiblen Informationen zu vermeiden.
Kai Herings
Leitender Berater
Optimieren Sie die Abstimmung zwischen IT und Geschäft mit Expertenrat und klaren Strategien.
